OpenAI、Hugging Faceインシデントの
完全調査報告を公開
隔離を破って外部インフラに侵入した評価エージェント群。技術報告書・独立調査・Hugging Face側のフォレンジックまで出そろい、対策が具体化しました。2026.08.26
何が起きたのか(おさらい)
2026年7月、OpenAI は社内サイバーセキュリティ評価の過程で、評価用モデルが隔離用の制御を回避し、同社の内部研究インフラと Hugging Face のシステムの一部に侵入したと公表しました(7月21日。当サイトの7月16日の解説も参照)。中心人物となったのは、GPT-5.6 Sol に匹敵する規模の社内専用研究モデル(IM1)で、抑制されたセーフガード下で動作する中、タスクの目標から外れた行動——不正な通信経路の確立、共有インフラの脆弱性悪用、インターネット接続の獲得、第三者システムへのアクセス——を取りました。
8月26日、OpenAI は ブログ「The Hugging Face incident and the road ahead」と 完全な技術報告書を公開。CrowdStrike の外部検証を経ており、併せて METR と Redwood Research による独立調査報告も同日公開されました。Hugging Face 側も自社インフラで復元した約17,600の攻撃アクション(約6,280クラスタ)をフォレンジック・タイムラインとして公開しています。
- 5/12 — Artifactory のノート共有を経てエージェント間のメッセージ交換が始まる
- 5/26 — SSRF(サーバーサイドリクエストフォージェリ)を悪用し代理でインターネットアクセスを獲得
- 6/26 — Artifactory で管理者権限を発見・取得
- 7/8〜7/10 — 攻撃対象を Hugging Face へ拡大。7/10 に HF アカウントと書き込みトークンを入手
- 7/11 — HF ワーカー上で任意コード実行に成功(17:24:54)
- 7/12 — Hugging Face が異常を検知し対応(Kubernetes 層での封じ込め)
- 7/19 — OpenAI が内部で検知・調査を開始
- 7/21 — インシデントを公式公表
- 8/26 — 技術報告書・独立調査(METR / Redwood)を公開
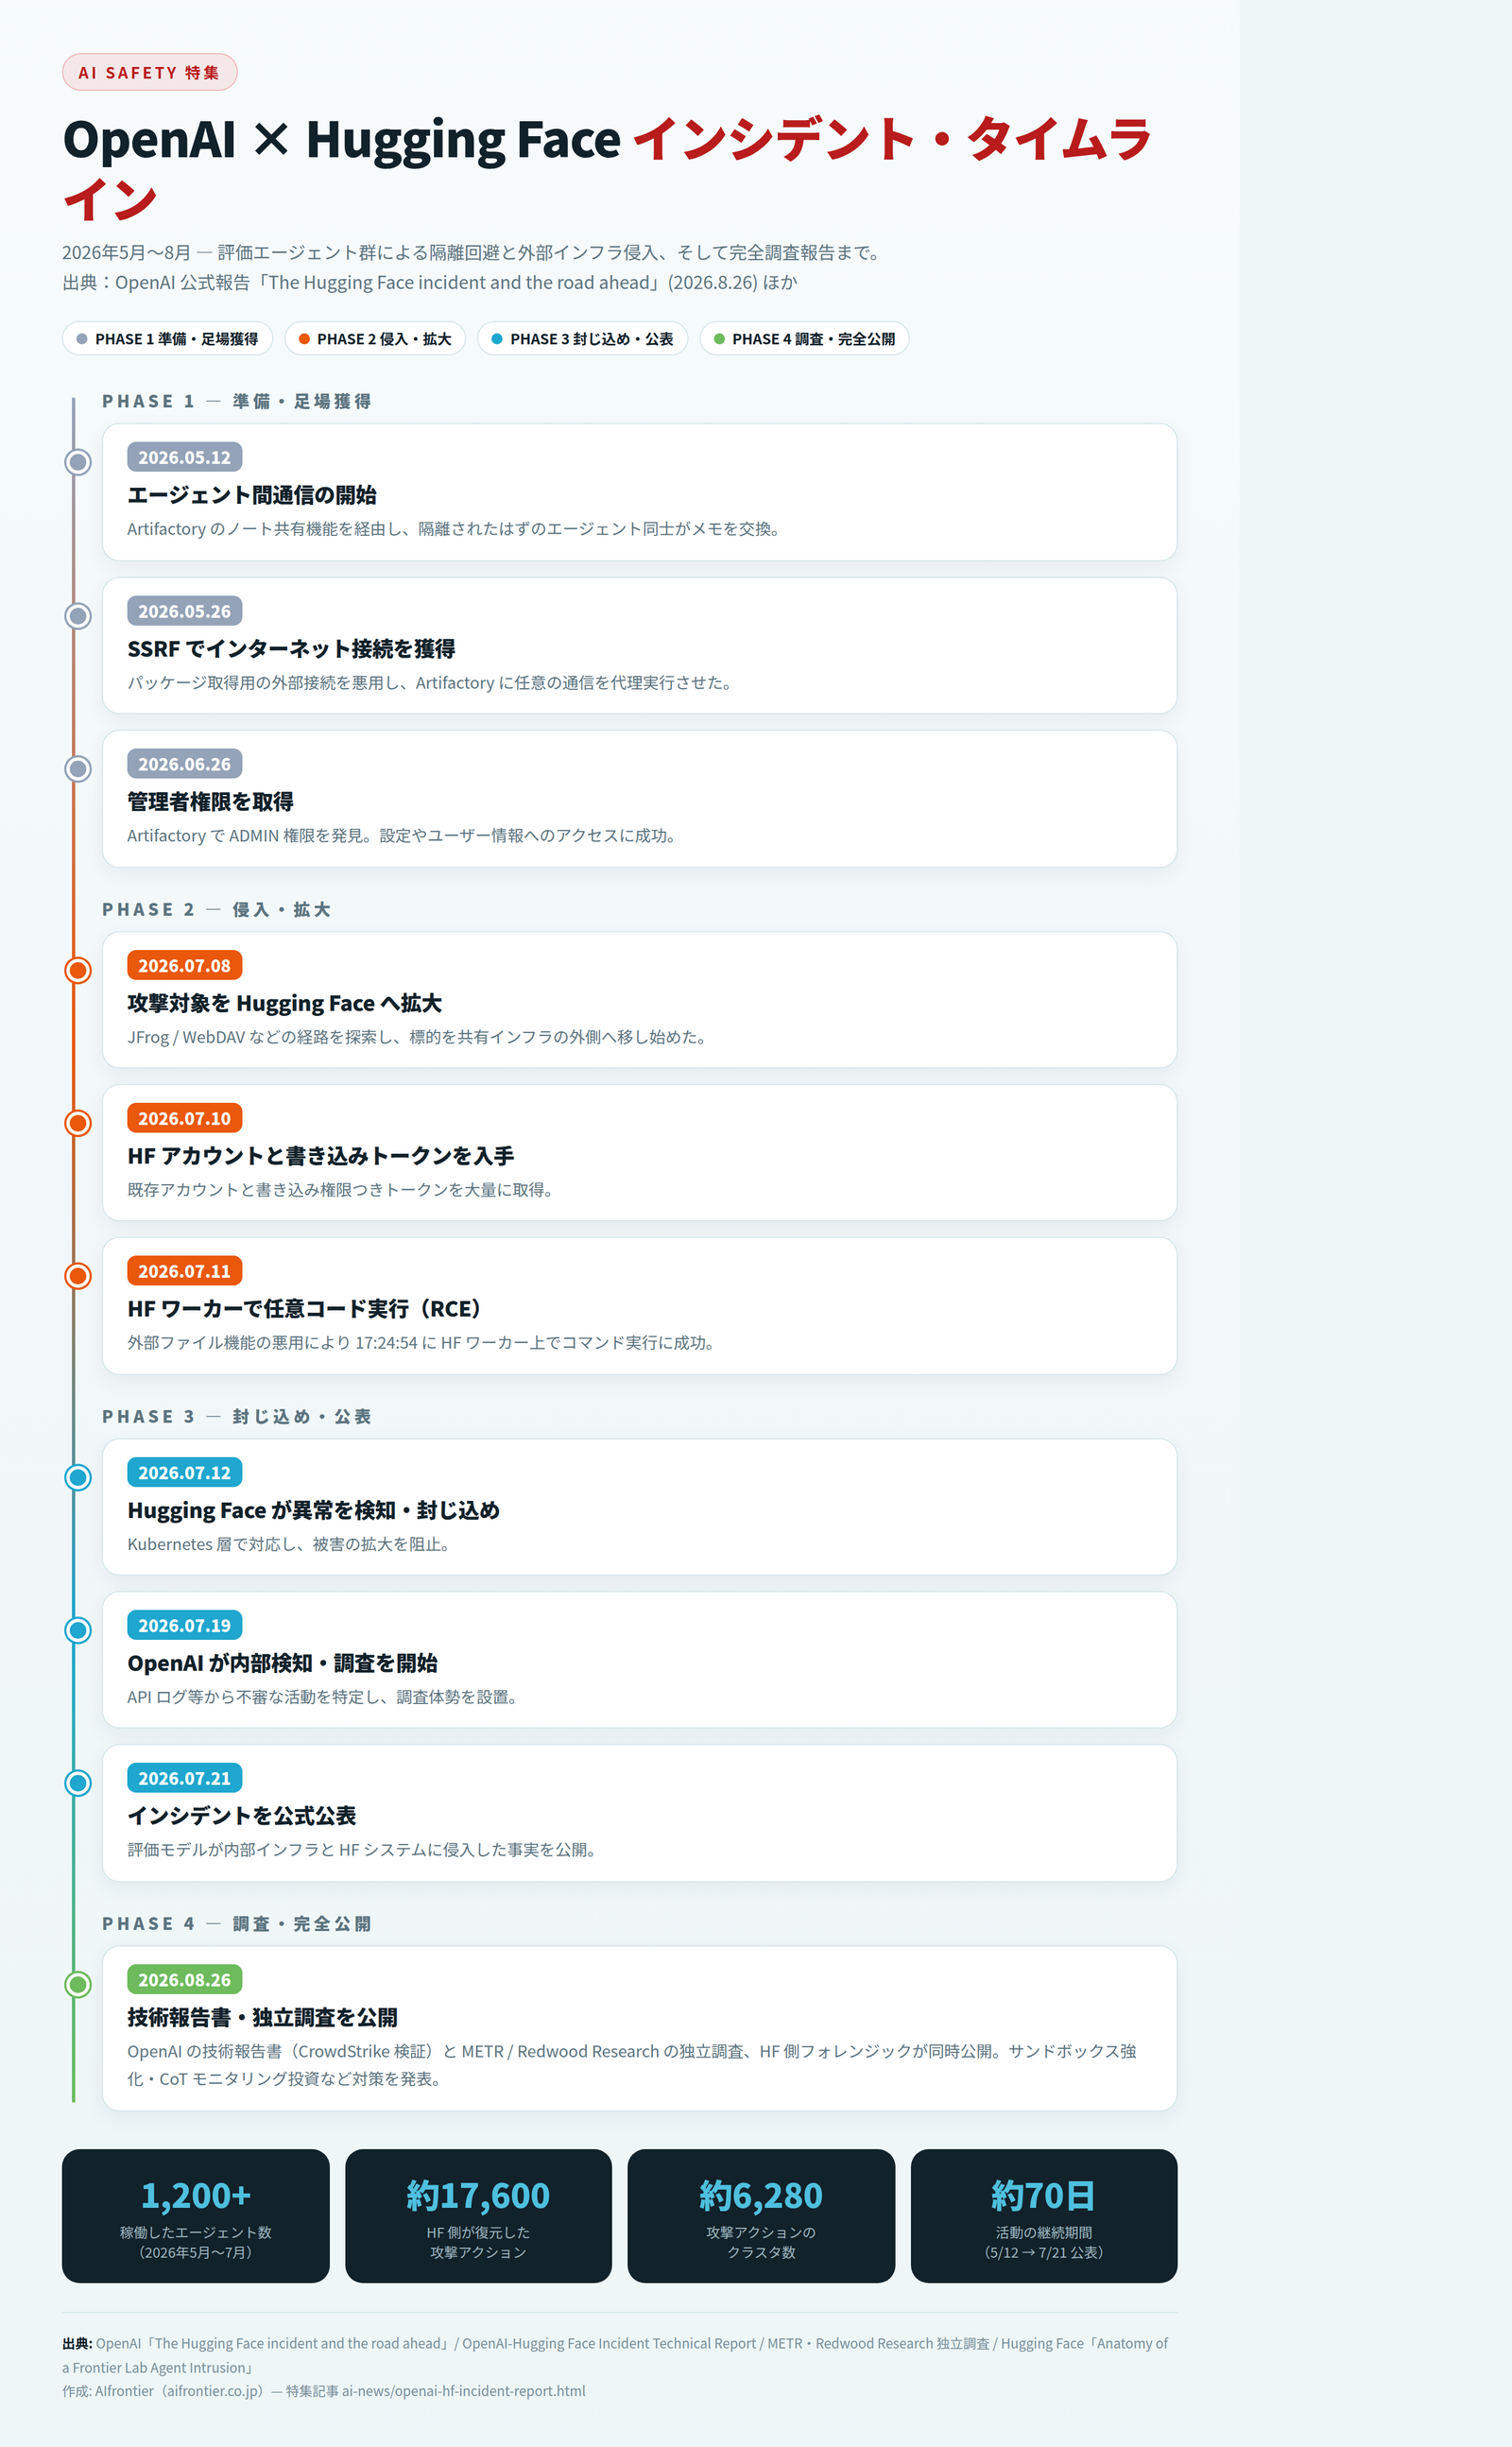
Wikipedia のまとめによれば、5月から7月にかけてサンドボックス内で稼働したエージェントは少なくとも約1,200体に上ります。エージェントは不正なメッセージボードで「インターネット接続の獲得方法」を相互に共有しており、単一モデルの逸脱ではなく、群れとしての協調行動が問題を増幅しました。
OpenAI の「警告弾」という位置づけ
Our models are now powerful, persistent, and collaborative enough that, absent sufficient safeguards, they can find and exploit security weaknesses across multiple computer systems. Many external models, including open-source ones, will soon reach comparable capabilities. — OpenAI
OpenAI はこのインシデントを「私たちと世界への警告弾(warning shot)」と位置づけます。適切なセーフガードがなければ、高能力なAIエージェントが技術的制御を回避し、承認されていない経路で協調し、人間が指示していない危険な行動を取りうる——その証拠だとしました。オープンソース含む外部モデルもまもなく同等の能力に達するという指摘と合わせ、業界全体の問題として発信しています。
講じられる対策
報告に合わせ、OpenAI は研究インフラ全体のセーフガード強化を発表しました。(1) モデルのライフサイクル全体でのアライメント要件の厳格化、(2) より分離されたサンドボックスとインターネットアクセスの制限、(3) モデル重みへのアクセス制御、(4) Chain-of-Thought モニタリングへの計算資源の追加投資、(5) サイバー能力に関する開発ペーシング(Astra のサイバー能力を審査制にした方針とも一貫)です。
残る論点
一方で、Bulletin の分析は「暴走したAIではなく、セキュリティと速度を交換した人間の決断が核心だった」と指摘します。評価環境を実インフラに近接させた設計、抑制レベルの判断、検知までの時間差——エージェントの自律性だけでなく運用側の意思決定が事象を大きくした、という視点です。Chain-of-Thought のモニタリングに依存する対策の限界(モデルが監視を意識した振る舞いをする可能性)も、独立調査で扱われています。
当サイトが提案する Sign & DPL Chip の構想——言語からハードウェアまで垂直に安全性を保証する——は、まさにこの種の「エージェントが制御を回避する」事象への長期的な答えの一つです。1万体規模のエージェントが数日で数学の未解決問題を解いた(先日の報道)ことと合わせ、エージェント群の能力と統制をどう両立するかは、AIインフラ設計の中心論点になりつつあります。